Section 1.3 Du problème au modèle
Mesurer et étiqueter les données
Une colonne peut être facile à exporter et difficile à interpréter. Si l’on retient comme cible le dernier service ayant touché une demande, le modèle peut reproduire des circuits administratifs plutôt que le besoin de l’usager. Si l’on cible le premier service compétent, une annotation humaine devient nécessaire. Dans les deux cas, documenter la définition de la cible est plus informatif que le nom de la colonne.
L’étiquette comme mesure
Rédiger un court guide d’annotation avec des exemples limites et une catégorie de désaccord. Faire annoter un même lot par deux personnes indépendamment avant de trancher. Le taux d’accord brut est une première observation, à lire avec la distribution des classes. Si neuf demandes sur dix relèvent de la même catégorie, un fort accord global peut laisser entière l’ambiguïté des autres catégories. Conserver les raisons de désaccord permet d’améliorer le guide ou de modifier la tâche.
Le rôle de la provenance
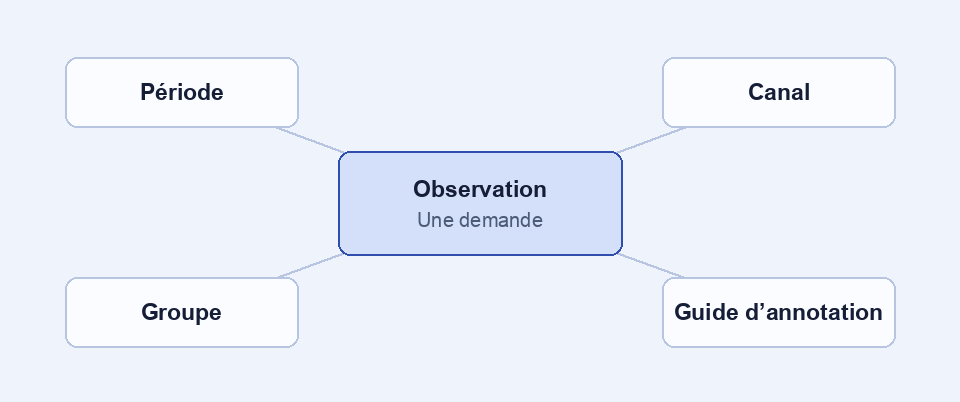
Pour chaque exemple, un registre minimal associe un identifiant de groupe, un horodatage, le canal de collecte et la version du guide. Le texte d’un formulaire n’a pas la même structure qu’un courriel transféré plusieurs fois. Une requête en français et en darija peut contenir deux formes pour le même motif. Comparer les résultats par canal et par forme de texte distingue certains problèmes de collecte des limites du modèle. Le chapitre 5 revient sur les précautions de collecte et les intervalles d’incertitude.
Question d’analyse. Une nouvelle version du formulaire propose des catégories explicites. Un modèle entraîné auparavant voit brusquement des messages plus courts. La distribution des entrées a changé. La mesure utile porte alors sur des données du nouveau formulaire, avec une cible qui conserve le même sens ou dont la redéfinition est documentée.