Section 5.1 Fiabilité et projet de synthèse
Auditer les performances par usage et par langue
Un résultat global pondère chaque cas comme le fait l’échantillon. Si un jeu est dominé par des requêtes en français, sa moyenne peut masquer les erreurs sur des requêtes en arabe ou en darija. Les catégories linguistiques elles-mêmes demandent une définition. Une requête peut changer de langue au milieu d’une phrase, contenir un nom propre ou utiliser plusieurs graphies. La grille doit distinguer la langue de la difficulté et du type de demande.
Interpréter les écarts
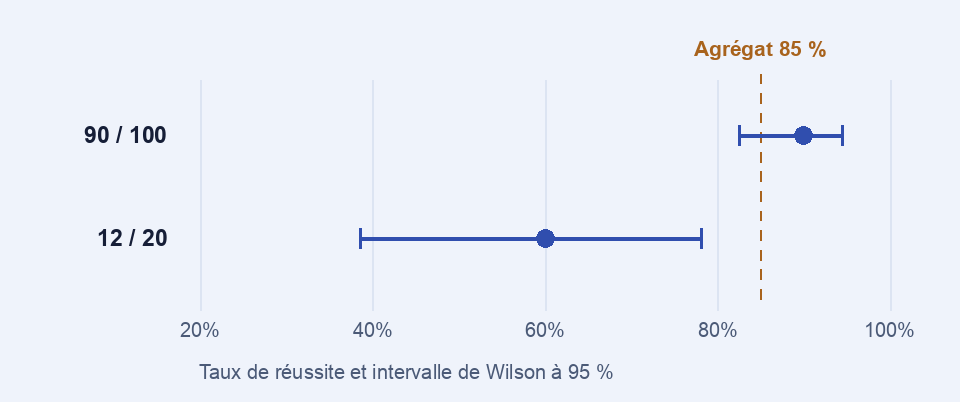
Dans un exemple construit, le système répond correctement à 90 des 100 questions du lot A et à 12 des 20 questions du lot B. L’agrégat est 102/120, soit 85 %. Les taux par lot sont 90 % et 60 %. Un intervalle de Wilson à 95 % pour B est approximativement [39 %, 78 %] si les observations sont indépendantes. Vingt reformulations écrites par une même personne peuvent être corrélées. Dans ce cas, traiter les observations comme des essais indépendants minimise l’incertitude. Les résultats servent à choisir les erreurs à étudier et à compléter les données.
Identifier la cause située en amont
Comparer d’abord des tâches appariées et examiner des erreurs de segmentation, de transcription, de recherche et de jugement. Si un assistant ne trouve pas un passage français depuis une requête en arabe mais répond correctement quand le passage est fourni, la recherche a échoué dans ce cas. Si le passage est présent puis mal expliqué, vérifier la génération et la grille de notation. Une correction ciblée peut alors être testée sur des cas comparables et sur un échantillon plus large.