Section 1.4 Du problème au modèle
Fonction de perte et descente de gradient
Considérons un estimateur linéaire ŷ = wx + b. Les paramètres w et b sont la pente et l’ordonnée à l’origine. La quantité x peut être un volume d’entrées normalisé et y le temps de travail correspondant, également exprimé dans une unité normalisée. Les deux observations de cette section servent à vérifier le calcul. Une prévision réelle exigerait un historique plus étendu et une évaluation temporelle.
ŷ = wx + b
L(w, b) = moyenne[(ŷ − y)²]
Un pas calculé à la main
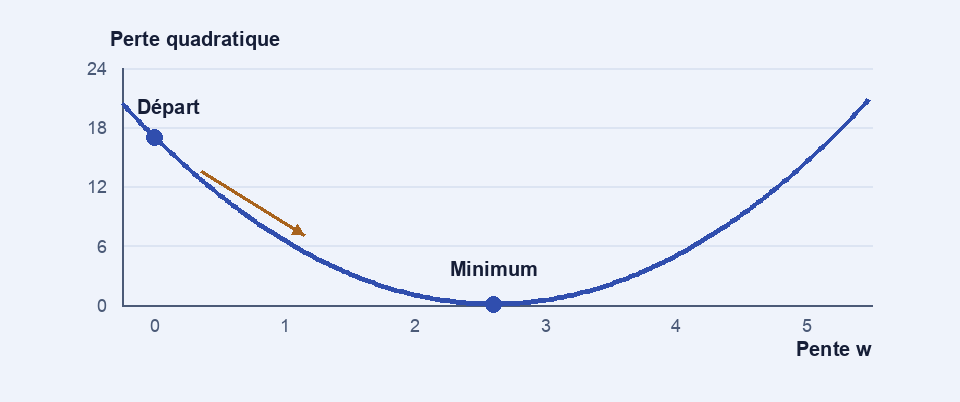
Pour (x, y) égaux à (1, 3) et (2, 5), initialiser w et b à zéro. Les résidus r = ŷ − y valent −3 et −5. La perte quadratique moyenne vaut (9 + 25) / 2 = 17. La dérivée par rapport à w est la moyenne de 2rx, soit −13. Celle par rapport à b est la moyenne de 2r, soit −8. Le signe négatif indique qu’une petite augmentation du paramètre réduit ici la perte, toutes choses égales par ailleurs.
Avec un pas η de 0,1, la mise à jour w ← w − η∂L/∂w donne w = 1,3 et b = 0,8. Les nouvelles prédictions sont 2,1 et 3,4, pour une perte de 1,685. Le calcul explicite révèle le rôle du taux d’apprentissage. Un pas trop grand peut dépasser la zone d’amélioration même si le gradient a été calculé correctement.
Choisir ce que la perte pénalise
La perte quadratique donne une importance croissante aux grands résidus. L’erreur absolue correspond souvent à une lecture métier plus directe. Un retard de dix minutes compte alors dix fois une erreur d’une minute, contre cent fois pour leurs carrés. Le critère d’entraînement et l’indicateur opérationnel peuvent être distincts. Les deux doivent être annoncés avant d’interpréter une amélioration.