Section 2.3 Apprendre et évaluer
Seuils, erreurs et calibration
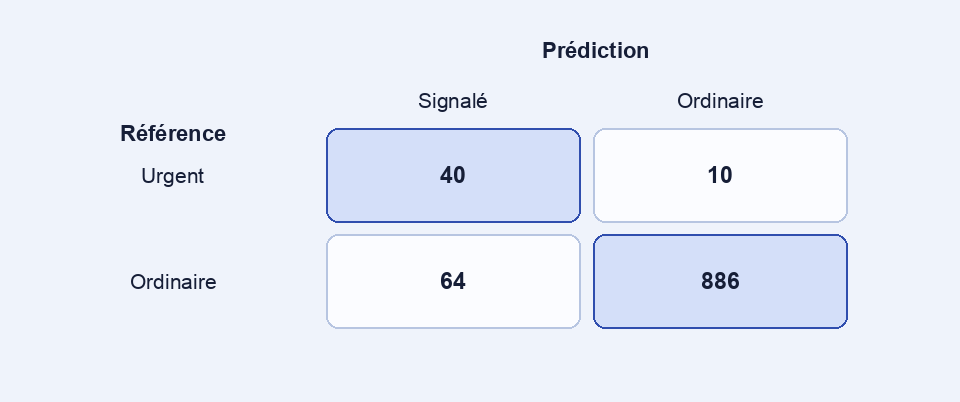
Sur un lot construit de 1 000 dossiers, 50 sont urgents. Un système qui considère chaque dossier comme ordinaire obtient 95 % d’exactitude et ne détecte aucune urgence. Le choix d’un seuil exige de lire les quatre cases de la matrice plutôt qu’un score global.
| Politique | Vrais positifs | Faux positifs | Faux négatifs | Vrais négatifs |
|---|---|---|---|---|
| A, seuil plus bas | 40 | 64 | 10 | 886 |
| B, seuil plus haut | 30 | 20 | 20 | 930 |
Lire ce que chaque dénominateur signifie
Pour A, le rappel est 40/50 = 80 %. La précision est 40/104 ≈ 38,5 %. Pour B, les deux valent 60 %. Le rappel regarde les urgences de référence. La précision regarde les dossiers signalés. Si une urgence manquée coûte huit unités et une revue inutile une unité, A coûte 144 unités et B en coûte 180 sur ce lot. Une limite de capacité à 60 revues changerait le choix. Les chiffres et les coûts sont construits pour exposer le raisonnement.
Un score de 0,8 signifie-t-il 80 % ?
Un score peut ordonner les demandes sans être une probabilité fiable. La calibration compare, par groupes de scores, la fréquence d’événements observée à la probabilité annoncée. Si les exemples prédits autour de 0,8 sont urgents dans environ huit cas sur dix, ce groupe est compatible avec une bonne calibration. Un groupe rare donne une mesure incertaine. Calibrer sur de nouveaux exemples de validation et conserver le test séparé, puis contrôler l’effet d’un changement de fréquence de base.