Section 3.5 Architecture des modèles génératifs
Modèles multimodaux et diffusion
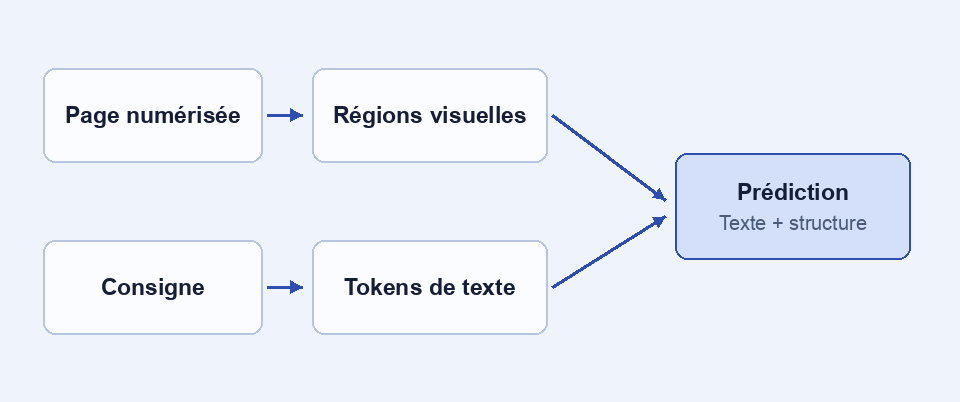
Un modèle multimodal utilise plus d’un type de signal. Un système de lecture de PDF peut recevoir le texte extrait, les coordonnées des blocs et des représentations visuelles de la page. Un transformer peut traiter des vecteurs calculés à partir de petits carrés d’une image. La sortie doit ensuite être évaluée avec la structure du document d’origine.
Lire un tableau dans une image
La valeur « 20 » est inutilisable hors de sa ligne et de sa colonne. Pour extraire un tableau horaire scanné, évaluer la correspondance entre cellule, en-tête et page, puis vérifier les lignes à cellules fusionnées. Comparer à une extraction textuelle puis à un OCR avec repérage des blocs. Un modèle multimodal peut compléter ces méthodes pour une page irrégulière. Un résultat au bon format peut toujours désigner la mauvaise cellule.
Générer une image par débruitage
Dans une famille de modèles de diffusion, l’entraînement ajoute du bruit aux observations à différents niveaux. Un réseau apprend une opération qui aide à inverser ce processus. En génération, l’algorithme part d’un bruit et applique des étapes successives de débruitage, éventuellement guidé par un texte. Certaines architectures travaillent dans un espace latent compressé. Le mécanisme diffère d’une suite de tokens textuels émise de gauche à droite. Ho, Jain et Abbeel présentent une formulation de référence. Dans les deux cas, une génération plausible doit être confrontée aux contraintes de la tâche, notamment les valeurs et axes d’un graphique technique.