Section 3.3 Architecture des modèles génératifs
Préentraînement, adaptation et post-entraînement
Pour un texte tokenisé t₁, …, tₙ, un objectif autorégressif demande à chaque position de prédire le token suivant. À l’entraînement, la continuation observée sert de cible. La log-vraisemblance négative pénalise fortement les cibles auxquelles le modèle assigne une probabilité très faible. Une prédiction de probabilité 0,1 coûte environ 2,303 nats, contre 0,223 à 0,8.
Que mesure la perplexité ?
La perplexité est l’exponentielle de la perte moyenne par token, lorsque la perte est mesurée avec un logarithme naturel. Un modèle qui distribue toujours sa probabilité de manière uniforme sur 10 possibilités a une perplexité de 10 sur des textes dont les cibles appartiennent à ce vocabulaire. Pour comparer deux perplexités, utiliser le même corpus, le même découpage et le même protocole. L’indicateur mesure la prédiction du texte observé. La réussite d’une tâche comme la citation exacte nécessite sa propre évaluation.
Modifier le modèle ou modifier sa requête
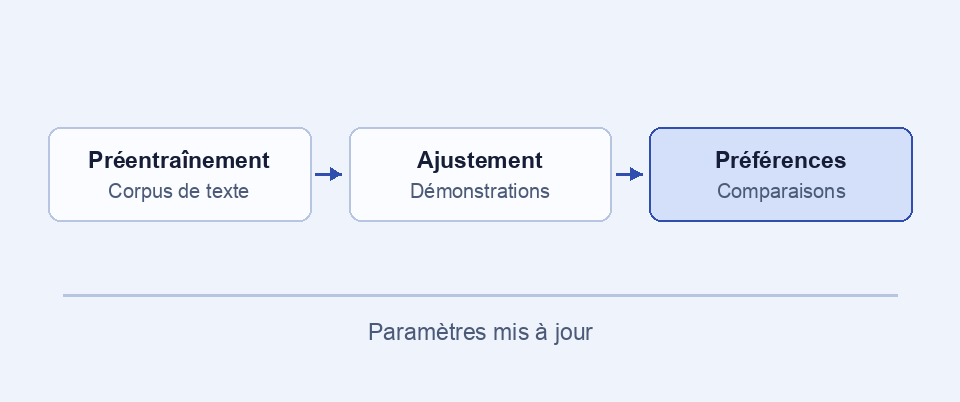
L’ajustement supervisé sur des démonstrations peut apprendre un format de dialogue. Des préférences entre réponses peuvent ensuite orienter le modèle vers des comportements choisis. Ouyang et al. donnent un exemple de chaîne avec retours humains. L’adaptation d’un modèle à un domaine peut aussi n’entraîner qu’un petit nombre de paramètres supplémentaires. Ajouter un document à la requête change le contexte au moment de l’inférence. Une mise à jour des paramètres, elle, modifie les calculs sur les demandes futures. Cette distinction détermine comment corriger une information devenue obsolète.