Section 3.4 Architecture des modèles génératifs
Décodage, contexte et coût d’inférence
À chaque pas, le modèle transforme la représentation de la dernière position en scores, appelés logits, pour les tokens du vocabulaire. Un décodage glouton choisit le plus grand score. Un décodage par échantillonnage tire un token selon une distribution. Le token sélectionné est ajouté à l’entrée avant le pas suivant.
Température et échantillonnage par masse
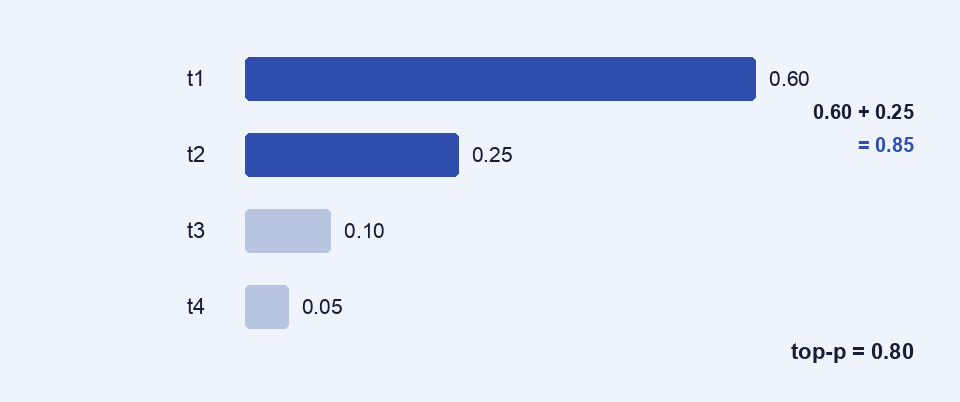
Pour une température T strictement positive, on applique le softmax aux logits divisés par T. Une petite valeur concentre la masse sur les scores élevés. L’échantillonnage top-p trie les tokens par probabilité et conserve le plus petit préfixe qui atteint une masse donnée, puis renormalise. Avec 0,60, 0,25, 0,10 et 0,05, un seuil de 0,80 conserve deux options. Leurs probabilités deviennent environ 0,706 et 0,294. Cette opération change la diversité des sorties. Les probabilités décrivent des continuations textuelles, avec toutes les limites de l’apprentissage sous-jacent.
Entrer dans la fenêtre de contexte
Instructions, historique, passages de référence et réponse partagent une capacité finie. Même lorsque les données tiennent dans la fenêtre, un élément important peut être négligé. Le temps du premier token inclut le traitement du texte d’entrée. La génération successive ajoute un délai à chaque token. Le cache clés-valeurs mémorise des calculs des positions précédentes afin d’éviter de les refaire à chaque pas, au prix de mémoire. Pour une tâche documentaire, raccourcir le contexte en retirant des documents peu pertinents peut améliorer à la fois le coût et la lisibilité de la preuve.