Section 5.4 Fiabilité et projet de synthèse
Arbitrer fiabilité, coût et latence
Un modèle plus grand ou un contexte plus long peut améliorer certaines réponses et compliquer le service. Une comparaison utile évalue donc plusieurs dimensions sur les mêmes demandes. Définir un temps de réponse mesuré du point de vue du lecteur, la limite de passages fournis et le coût des demandes reprises par une personne.
Mesurer des compromis observables
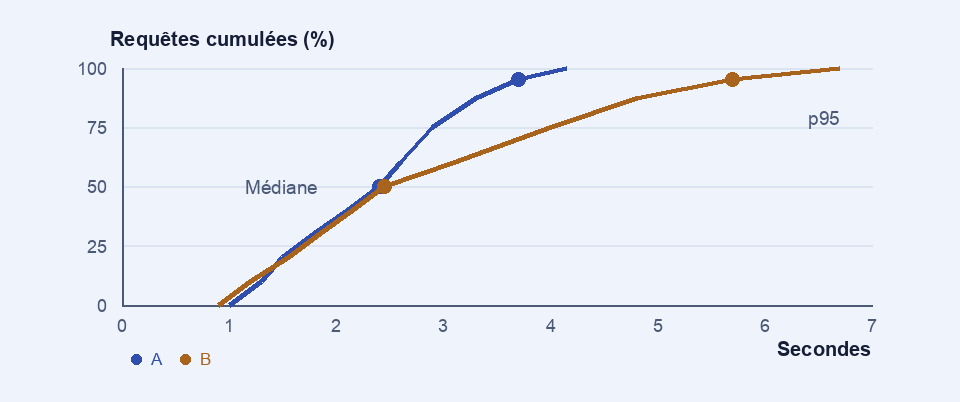
Le temps médian décrit une requête typique sous le protocole observé. Le 95e centile décrit un seuil sous lequel se trouvent environ 95 % des temps, selon la convention d’estimation choisie. Une moyenne ne montre pas les requêtes longues qui peuvent rendre une interaction difficile. Enregistrer séparément recherche, traitement des entrées et génération permet de localiser le délai. Un service peut renvoyer rapidement un extrait puis préparer une synthèse lorsque la preuve est suffisante.
Mettre l’abstention au bilan
Une stratégie qui traite 60 demandes sur 100 et répond correctement à 54 des 60 donne 90 % de réussite parmi les réponses et 60 % de couverture. Une autre en traite 90 et a raison sur 72, soit 80 % sur les réponses et 90 % de couverture. Les résultats n’impliquent pas le même travail de suivi. Comparer les erreurs coûteuses, la couverture et la capacité de revue. En exploitation, compter aussi les réessais, les réponses incomplètes et les problèmes de source.