Section 3.1 Architecture des modèles génératifs
Tokenisation et représentations vectorielles
Un modèle de langage reçoit des identifiants. Le tokenizer découpe une chaîne et encode chaque morceau avec un identifiant de son vocabulaire. Les frontières peuvent séparer un mot, intégrer un espace ou correspondre à des octets. Le contexte consommé par une phrase dépend du tokenizer et de la forme exacte du texte.
Les unités sont apprises sur un corpus
Une méthode proche du byte-pair encoding (BPE) commence avec des symboles de base. Elle compte les paires adjacentes et fusionne de façon répétée une paire fréquente. La table des fusions sert ensuite à tokenizer de nouveaux textes. Des variantes modifient l’alphabet initial, le nettoyage et les règles de segmentation. Un vocabulaire contenant une suite fréquente peut encoder tout un fragment en un seul identifiant, là où une forme rare est représentée par plusieurs identifiants. Les travaux de Sennrich et al. décrivent cette idée dans le contexte de la traduction.
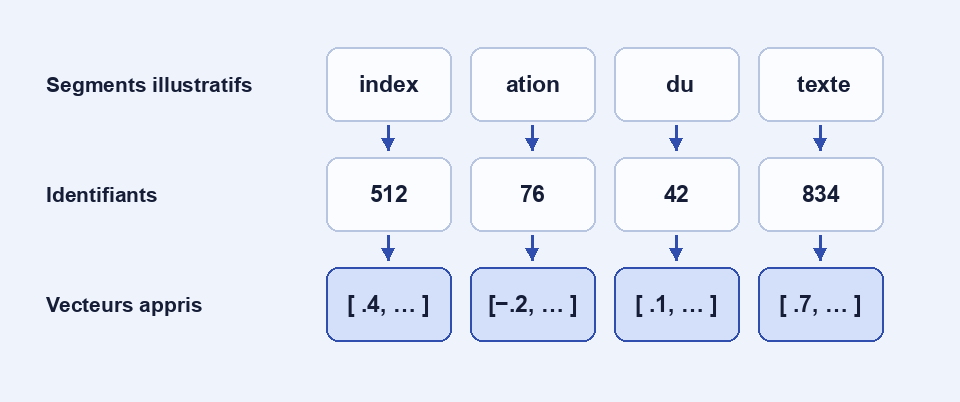
Identifiant, embedding et représentation contextualisée
L’identifiant est une adresse. Le plongement (embedding) est la ligne numérique sélectionnée à cette adresse dans une table apprise. Dans une table à 50 000 tokens et 768 coordonnées, on compte 38,4 millions de valeurs. Les couches transforment ensuite le vecteur en fonction des autres positions accessibles. Deux occurrences d’un même token partent du même embedding de token, mais peuvent aboutir à des représentations différentes.
Analyse multilingue. Mesurer séparément le nombre de tokens par caractère ou par mot sur des textes comparables en arabe, en français et en darija latinisée. Préciser le tokenizer, la normalisation Unicode et l’échantillonnage. Ce ratio renseigne sur l’utilisation du contexte. Il ne mesure pas directement la qualité des réponses.