Section 2.5 Apprendre et évaluer
Réseaux profonds et représentations apprises
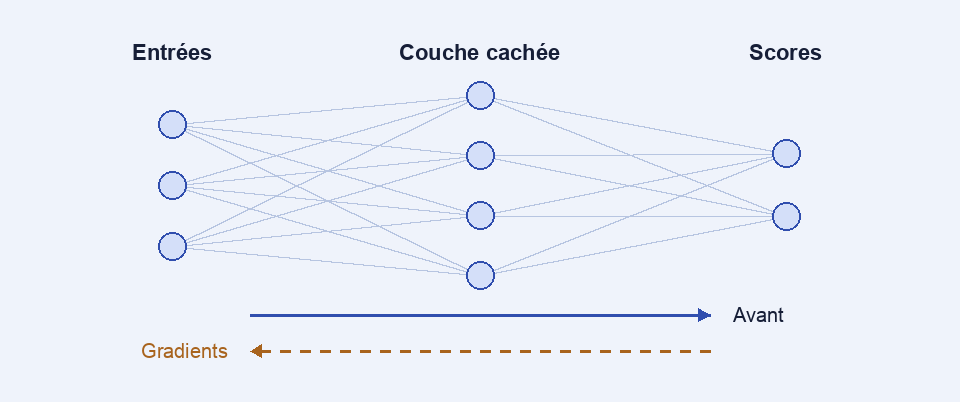
Un réseau construit des représentations en composant des transformations. Une couche dense calcule z = Wx + b puis applique une activation, par exemple ReLU(z) = max(0, z) coordonnée par coordonnée. Empiler uniquement des transformations affines se ramène toujours à une transformation affine. Les non-linéarités permettent de construire des frontières de décision plus riches.
Du calcul avant à la mise à jour
Un passage avant calcule les prédictions et la perte. La rétropropagation applique la règle de la chaîne au graphe de calcul pour obtenir les gradients des paramètres. L’optimiseur les utilise ensuite pour décider de la mise à jour. Cette distinction permet de diagnostiquer une mauvaise loss, des gradients quasi nuls ou un taux d’apprentissage excessif à trois endroits différents.
Transférer une représentation
Un encodeur préentraîné peut servir à produire des vecteurs pour un petit classificateur supervisé. Geler l’encodeur réduit le nombre de paramètres à ajuster. Un réentraînement partiel peut adapter la représentation au domaine, mais augmente le coût et le risque d’ajustement au lot disponible. Comparer sur le même test un modèle à mots ou caractères et un encodeur permet de savoir si le gain vaut le coût. En vision, les convolutions exploitent la localité spatiale. En langage, le transformer organise des interactions entre positions, étudiées au chapitre 3.
Question de synthèse. Si l’encodeur améliore le score global mais dégrade la reconnaissance des dossiers rares, examiner les erreurs par classe et comparer les politiques permises. Le choix dépend de la sortie et de son coût, comme dans la première section du manuel.