Section 3.2 Architecture des modèles génératifs
Attention causale et architecture transformer
L’auto-attention construit un mélange pondéré de représentations issues de différentes positions. Pour chaque position, des transformations apprises produisent un vecteur requête q, une clé k et une valeur v. La requête est comparée aux clés par produit scalaire. Les scores divisés par √dₖ passent dans un softmax, qui les transforme en poids positifs de somme 1 sur les positions autorisées. La sortie est la somme pondérée des valeurs.
sⱼ = (q · kⱼ) / √dₖ
αⱼ = exp(sⱼ) / Σᵢ exp(sᵢ)
sortie = Σⱼ αⱼvⱼ
Un calcul que l’on peut reproduire
Pour une requête q = (1, 0), deux clés (1, 0) et (0, 1) et une dimension dₖ de 2, les scores mis à l’échelle sont 1/√2 et 0. Le softmax donne environ 0,670 et 0,330. Avec les valeurs (2, 0) et (0, 2), le résultat est environ (1,340 ; 0,660). Les clés sélectionnent des contributions. Les valeurs transportent les nombres à combiner. Un modèle réel apprend ces transformations sur les données.
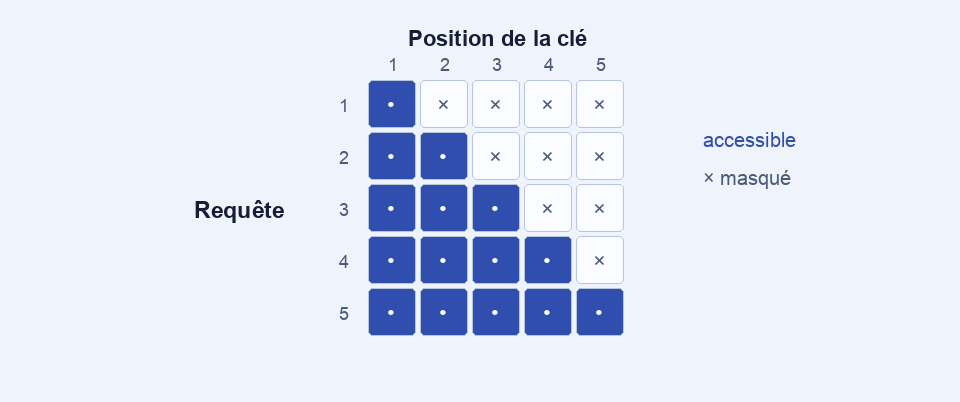
Pourquoi masquer les positions futures ?
Dans un décodeur autorégressif, une position doit utiliser seulement sa propre entrée et les entrées précédentes pour prédire la suivante. Le masque empêche de lire la réponse lors de l’entraînement. Les positions sont aussi rendues identifiables par un mécanisme de position. Un bloc transformer associe plusieurs têtes à des transformations par position, des connexions résiduelles et des normalisations. Vaswani et al. décrivent l’architecture d’origine dans un cadre encodeur-décodeur.